Около полугода назад, я уже
сравнивал семантические фреймворки и ризонеры. Если на том этапе для меня важнее был выбор удобного фреймворка, нежели производительность, безопасность и т. д. (и выбор пал на OWLAPI+Pellet), то сейчас нашему проекту нужен высокопроизводительный ризонер с хранилищем в виде базы данных. Посему предлагаю рассмотреть и по возможности сравнить доступные на рынке SAIL-решения (Storage And Inference Layer).
Разделю хранилища на две группы: независимые (назовем их standalone) и являющиеся частью комплексных семантико-ориентированных enterprise-систем (для краткости дальше они будут именоваться PESSS-хранилища - Part of Enterprise Semantic System Store).
Сначала рассмотрим первую группу.
Standalone-хранилища
AllegroGraph
Официальный сайт: http://www.franz.com/agraph/allegrograph/Цена: Бесплатно до 50 миллионов триплетов. При превышении лимита: Developer Edition: $4195 за процессор, Enterprise Edition: $34995 за процессор; академическая скидка - 50%. RacerPro продается отдельно; стоимость его лицензии можно узнать
на официальном сайте (цены примерно того же порядка).
Поддерживаемые фреймворки: Jena, Sesame, Clojure
Архитектура: 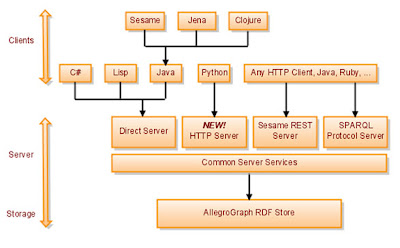 Описание:
AllegroGraph разрабатывает фирма Franz Inc., которая широко известна благодаря таким продуктам, как TopBraid Composer (редактор онтологий), RacerPro (OWL DL ризонер) и др.
Поддерживает 2 основных типа вывода:
1. RDFS++Уж как только не называют "RDFS плюс немного OWL"... На сей раз имеются в виду следующие предикаты: rdf:type, rdfs:subClassOf, rdfs:range, rdfs:domain, rdfs:subpropertyof, owl:sameAs, owl:inverseOf, owl:TransitiveProperty, owl:hasValue.
2. RacerProAllegroGraph интегрирован с еще одним ризонером Franz Inc. - RacerPro, который имеет выразительность OWL DL. Обсуждение OWL DL ризонеров в некоторой степени выходит за рамки сегодняшней статьи (ибо высокопроизводительными их пока назвать сложно), однако мы еще коснемся RacerPro при обсуждении PelletDb.
Итак, AllegroGraph является RDF-хранилищем с поддержкой двух ризонеров с полярными характеристиками. Впечатляет.
Franz Inc. также разрабатывает проект
AGWebView, который, как несложно догадаться из названия, представляет собой Web-интерфейс для AllegroGraph.
BigOWLIM
Официальный сайт: http://www.ontotext.com/owlim/big/Цена: 700 евро за каждое процессорное ядро
Поддерживаемые фреймворки: Sesame
Архитектура: Реализует SAIL для Sesame
Описание:BigOWLIM имеет выразительность "RDFS with most of OWL Lite" (
здесь подробнее), которая чуть шире выразительности ризонера RDFS++ AllegroGraph.
Разработчики OWLIM не скромничают и заявляют, что "BigOWLIM is
the most scalable and efficient RDF Database!"
Интересно было бы сравнить производительность BigOWLIM с AllegroGraph RDFS++, но сделать это не так просто, ибо ризонеры базируются на разных принципах: static и dynamic materialization соответственно. Разобраться в различиях поможет
описание RDFS++ dynamic materialzation (кстати, в видео идет сравнение с OWLIM). Итак, в теории AllegroGraph RDFS++ должен
1. быстрее загружать онтологии (ибо при этом ему не нужно делать вывод)
2. абсолютно безболезненно переживать модификацию онтологии
3. дольше выполнять запросы (ибо каждый запрос требует выполнения логического вывода).
От теории перейдем к практике и сравним результаты теста LUBM(8k) (информация взята
отсюда и
отсюда) при использовании сопоставимых конфигураций:
- BigOWLIM: Core i7 940 (2.93GHz, quad-core, HT), 12GB (DDR3), 3x320GB 7.2krpm, RAID 0
- AllegroGraph: Quad 1.8GHz AMD64 Opteron 884, with 16Gb of memory running Fedora 8
 Все с ног на голову.
AllegroGraph показал в два раза худшее время загрузки (и это при том, что BigOWLIM во время загрузки еще и вывод делает). Так как у тестовой конфигурации AllegroGraph отсутствовала информация о дисковой подсистеме, пришлось восполнить этот пробел при помощи службы поддержки. Оказалось, использовались 2 обычных Sata диска, не объединенных в RAID (что равносильно одному диску). Если учесть преимущество на этапе загрузки в скорости тройного RAID 0 (используемого для тестирования BigOWLIM) против обычного диска, все встает на свои места.
А вот объяснить четырехкратное преимущество AllegroGraph при выполнении запросов (особенно при том, что теоретически на этом этапе он должен проигрывать BigOWLIM), пожалуй, можно лишь тем, что у AllegroGraph отлично реализованы алгоритмы вывода и поиска.
Подведем итоги локального сравнения.
В теории все звучит предельно ясно: чем более динамично меняется онтология, тем лучше себя показывает dynamic materialization; и наоборот. На практике же не все так однозначно: многое решают нюансы реализации.
Несмотря на то, что AllegroGraph производит впечатление гораздо более мощной, целостной и функциональной системы, BigOWLIM определенно достоин внимания при выборе высокопроизводительного RDF-хранилища (особенно учитывая колоссальную разницу в стоимости лицензий).
PelletDb
Официальный сайт: http://clarkparsia.com/pelletdb
Цена: EULA-лицензия на PelletDb - 2495$ + лицензия на Pellet (если ваш проект распространяется по GPL, Pellet бесплатен) EULA 4995$ за сервер + лицензия Oracle Enterprise.
Поддерживаемые фреймворки: Jena
Архитектура: Взаимодействует с Oracle Enterpise при помощи
Jena Oracle AdaptorОписание:
Сомневался, в какую категорию поместить PelletDb. С одной стороны, что может быть "более enterprise", чем Oracle, с другой, - категория PESSS подразумевает семантико-ориентированность enterprise-системы. А в Oracle реализовано лишь хранилище с ризонером да SPARQL-endpoint. Я посчитал, что этого недостаточно для попадания в категорию PESSS. Кроме того, при таком раскладе в обоих категориях по три продукта :) В любом случае, это не принципиально.
Совсем "свеженький" продукт (релиз состоялся 1 декабря текущего года), реализующий для Oralce Enterprise логический вывод с выразительностью OWL DL.
Работает PelletDb следующим образом:
1. При помощи Jena Oracle Adaptor загружает из Oralce триплеты
2. Делает полный вывод
3. Загружает выведенные триплеты обратно в Oracle
Вырисовываются два существенных минуса такого подхода:
1. Для вывода вся модель должна быть в памяти. Это существенно снижает целесообразность использования PelletDb в enterpise-проектах (а жесткая привязка к Oracle Enterprise диктует использование PelletDb именно в этом секторе). Конечно же, разработчики учли этот "нюанс", поэтому PelletDb поддерживает (подробности в
pelletdb whitepaper) режим вывода только схемы (=TBox). При этом в результате мы получим ABox, выведенный ризонером Oracle, и TBox, выведенный PelletDb.
2. Если "классический" Pellet делает вывод динамически, то PelletDb, очевидно, делает его статически. Полный OWL DL вывод - это очень медленно. Здесь бы пригодился динамический вывод... но используемая архитектура его не предполагает. В этом отношении интереснее смотрится связка RacerPro (OWL DL ризонер, который мы упоминали выше) и AllegroGraph. Ведь это продукты одной фирмы, а значит у них больше гибкости в вопросе интеграции.
<Лирическое отсупление на тему RacerPro>
В RacerPro можно выделить два режима работы.
В первом режиме происходит inmemory-вывод, который влечет за собой ограничение на размер ABox (аналогичен первому режиму PelletDb). В качестве решения можно отказаться от вывода ABox при помощи RacerPro, положившись на RDFS++ ризонер AllegroGraph (аналогично второму режиму PelletDb). Есть еще альтернативное решение, которое предполагает разбиение ABox на независимые части, которые выводились бы отдельно друг от друга. Пока это можно сделать только вручную, но уже в будущей версии для этого будет специальный API, а в более далекой перспективе обещают реализовать автоматический алгоритм разбиения ABox.
Второй режим не требует загрузки всей модели в память. Правда есть серьезные ограничения: нужно либо смириться с возможной неполнотой вывода, либо с тем, что для полного вывода RacerPro придется при каждом запросе обрабатывать всю базу.
</Лирическое отступление на тему RacerPro>
В целом PelletDb выглядит слишком узконаправленным: он заточен не только под Oracle Enterprise, но еще, по сути, под вывод лишь TBox. А ведь стоит недешево. Хотя, с другой стороны, "Everything is better with Bluetooth Oracle" :)
PESSS-хранилища
Virtuoso
Официальный сайт: virtuoso.openlinksw.comЦена: Virtuoso Open Source Edition бесплатна. На нее распространяется ограничение соединения с внешними базами данных, отсутствие поддержки репликации и Virtual Database. Цену на подходящую вам конфигурацию коммерческой версии можно узнать на
официальном сайте, выбрав Virtuoso Universal Server.
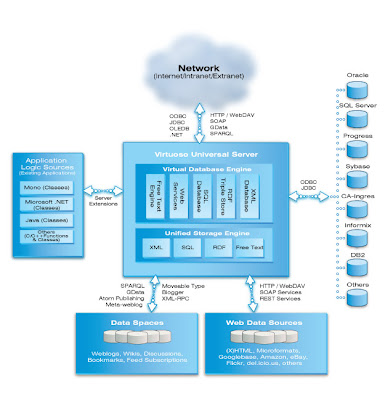
Описание:
Virtuoso - очень мощный Enterprise-продукт фирмы OpenLink, которая специализируется на разработке RDBMS Middleware.
В состав Virtuoso входит одно из самых производительных и масштабируемых (например, сейчас в этом LOD-хранилище числится более 9 гигаквад) RDF-хранилищ, снабженных изощренной SPARQL-endpoint с поддержкой RDF Views. RDF Views - это реализация RDBMS2RDF, позволяющая динамически работать с реляционными данными через SPARQL (незаменимая возможность для проектов, ориентированных на интеграцию данных).
Выразительность встроенного ризонера довольно скромная: поддерживаются rdfs:subClassOf, rdfs:subPropertyOf, owl:equivalentClass, owl:equivalentProperty и owl:sameAs.
Отдельного упоминания стоит обилие качественной документации по Virtuoso.
OpenAnzo
Официальный сайт: http://www.openanzo.org/Цена: Бесплатно (Eclipse Public License -v 1.0)
Описание:OpenAnzo представляет собой RDF-хранилище с широким спектром семантического middleware, которое включает поддержку распределенных сервисов, работу в оффлайн, версионирование, ограничение доступа и т. д.
Одна из концепций данного проекта - ориентация на сервисы. Так, например, упомянутое выше RDF-хранилище, именуемое Anzo Store, не является хранилищем в привычном понимании этого слова. Anzo Store - это data-source-сервис, реализующий хранение триплетов в реляционных СУБД. Другой пример использования сервисов - синхронизация информации, реализованная при помощи сервисов репликации и уведомлений.
Встроенный ризонер отсутствует. В качестве решения этой проблемы предлагается выводить триплеты при помощи внешнего ризонера (а актуализировать информацию при помощи упомянутых выше сервисов репликации и уведомлений) или встроить вызов ризонера в обработчик SPARQL-запросов.
Предоставляется клиентский API для Java, .NET и JavaScript.
В целом, очень интересный Open Source проект с широким enterprise-функционалом.
Официальный сайт: http://www.intellidimension.com/products/semantics-server/Цена: В зависимости от версии: например, Standard Edition License - 10000$, Enterprise Edition License - 15000$ + лицензия Microsoft SQL Server.
Описание:Одна из немногих семантических разработок на .NET. Причем не просто на .NET, а в тесном сотрудничестве с Microsoft.
Semantics.Server представляет собой целый ряд средств, включая свой фреймворк, OWL Full ризонер и хранилище на базе SQL Server. Особенно хотелось бы отметить следующие возможности:
1. Объединение реляционных и семантических данных
при помощи T-SQL (в отличие от Virtuoso RDF Views, другие СУБД не поддерживаются)
2. Распределение одного RDF-графа на множество серверов.
В maillist'е Semantics.Server периодически появляются сообщения о низкой производительности продукта по сравнению с конкурирующими системами. Публичных тестов практически нет, но подобные отзывы полностью коррелируют с моим опытом использования Semantics.Server. Поэтому перед тем, как воспользоваться возможностью распределения RDF-графа на множество серверов, стоит проверить: может выйти так, что конкурирующий продукт решит поставленную задачу в заданные сроки даже на одном сервере.
Также серьезным недостатком Semantics.Server является ограниченная поддержка других (помимо SQL Server) СУБД. Хотя работа в этом направлении ведется:
"Yes, it only works with SQL Server at the moment using out of the box components (you could write a custom datasource component to connect to any external source of data). We do expect to support access to additional relational stores using our SQL Datasource, but have no timeline for that right now."
Заключение
Пожалуй откажусь от идеи делать выводы уровня must live/must die касательно вышеописанных продуктов: уж слишком они все разные.
В обзоре были рассмотрены далеко не все существующие продукты. Буду рад увидеть в комментариях дополнение этого поста.


